Jak działa wyszukiwarka Google?
Po opublikowaniu strony internetowej Google musi ją najpierw odnaleźć, następnie przeskanować jej zawartość i zdecydować, czy warto dodać ją do swojego indeksu. Dopiero później strona może zostać dopasowana do zapytania użytkownika i pojawić się w wynikach wyszukiwania.
Te etapy łatwo ze sobą pomylić, choć każdy oznacza coś innego. Znalezienie strony oznacza wykrycie jej adresu, indeksowanie polega na analizie i zapisaniu informacji o stronie, a wyświetlenie w wynikach Google zależy od tego, czy dana treść pasuje do intencji użytkownika i spełnia kryteria jakości.
Spis treści
Jak działa wyszukiwarka Google?
Wyszukiwarka Google działa jak rozbudowany system odkrywania, analizowania i porządkowania informacji dostępnych w internecie. Jej zadaniem jest znalezienie stron, zrozumienie ich zawartości, zapisanie informacji o nich oraz późniejsze dopasowanie odpowiednich wyników do zapytania użytkownika.
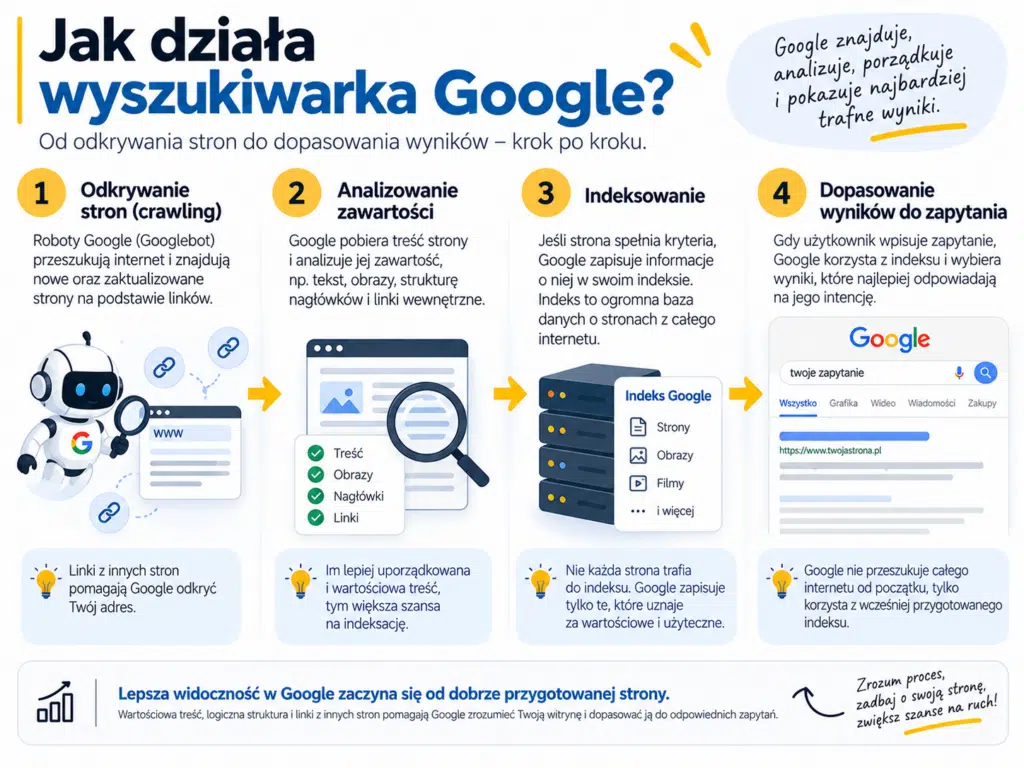
Samo opublikowanie strony internetowej nie oznacza jednak, że automatycznie pojawi się ona w Google. Najpierw wyszukiwarka musi odkryć jej adres, następnie robot Google pobiera i analizuje zawartość strony. Jeśli chcesz lepiej zrozumieć, jak indeksować stronę, warto pamiętać, że dopiero po przeanalizowaniu treści Google może zapisać potrzebne informacje w swoim indeksie i uwzględniać stronę przy późniejszych wyszukiwaniach.
Gdy użytkownik wpisuje zapytanie, Google nie przeszukuje całego internetu od początku. Korzysta przede wszystkim z wcześniej przygotowanego indeksu wyszukiwarki i wybiera z niego wyniki, które uznaje za najbardziej trafne oraz użyteczne w danym kontekście. Cały proces obejmuje więc odkrywanie stron, skanowanie, indeksowanie oraz późniejsze dopasowanie wyników do intencji użytkownika.
Jak Google znajduje nowe strony internetowe?
Google znajduje nowe strony przede wszystkim poprzez linki prowadzące z innych znanych już adresów URL oraz informacje przekazywane w mapie witryny. Gdy robot Google odwiedza stronę, analizuje znajdujące się na niej odnośniki i może przejść do kolejnych podstron. W ten sposób wyszukiwarka odkrywa zarówno nowe treści, jak i adresy, które zostały wcześniej zaktualizowane.
Duże znaczenie ma więc linkowanie wewnętrzne. Jeśli nowa podstrona jest dostępna z menu, kategorii, artykułu lub innego miejsca w serwisie, Google ma większą szansę szybko ją odnaleźć. Strona, do której nie prowadzi żaden odnośnik, może być trudniejsza do wykrycia, szczególnie jeśli jej adres nie został wskazany również w mapie witryny.
Samo odkrycie adresu nie oznacza jeszcze, że pojawi się on w wynikach wyszukiwania. Google musi następnie pobrać zawartość strony, przeanalizować ją i zdecydować, czy powinna zostać uwzględniona w indeksie. Odkrywanie adresów jest więc dopiero początkiem całego procesu.
Potrzebujesz skuteczniejszego SEO?
Jaką rolę pełni mapa witryny?
Mapa witryny przekazuje Google informacje o adresach URL, które właściciel serwisu uznaje za istotne. Jeśli korzystasz z WordPressa, pomocny może być również temat yoast seo sitemaps, ponieważ dotyczy generowania i obsługi mapy witryny. Plik sitemap ułatwia wyszukiwarce odnajdywanie podstron i może zawierać również informacje wskazujące, że dana treść została zaktualizowana.
Mapa witryny jest szczególnie przydatna przy dużych sklepach internetowych, rozbudowanych portalach oraz serwisach, w których regularnie pojawiają się nowe strony. Pomaga Google zorientować się, które adresy warto odwiedzić, zwłaszcza gdy struktura serwisu jest rozbudowana lub część treści znajduje się głęboko w architekturze strony. Dodanie adresu do sitemap nie jest jednak gwarancją jego indeksowania. Mapa witryny pomaga Google odkrywać strony, ale nie wymusza ich obecności w indeksie. Ostatecznie wyszukiwarka analizuje każdy adres osobno i decyduje, czy jego zawartość powinna być brana pod uwagę podczas prezentowania wyników użytkownikom.
Czym jest crawling w Google?
Crawling w Google to proces skanowania stron internetowych przez roboty wyszukiwarki. Najbardziej znanym z nich jest Googlebot, który odwiedza adresy URL, pobiera ich zawartość i sprawdza, jakie informacje oraz linki znajdują się na stronie. Można to porównać do automatycznego przeglądania internetu, podczas którego Google poznaje strukturę serwisów i odkrywa kolejne dokumenty.
Podczas skanowania Googlebot może pobierać kod HTML, obrazy oraz inne zasoby potrzebne do prawidłowego odczytania strony. Jeśli część elementów jest niedostępna, wyszukiwarka może zobaczyć witrynę inaczej niż jej użytkownik. Z tego powodu dostępność serwera i zasobów strony ma bezpośrednie znaczenie dla procesu skanowania.
Samo odwiedzenie adresu przez Googlebota nie oznacza jeszcze, że zostanie on zaindeksowany. Crawling pozwala Google zebrać dane, które następnie mogą zostać przeanalizowane w kolejnym etapie. Dopiero wtedy wyszukiwarka ocenia zawartość strony i jej przydatność dla indeksu.
Co może utrudniać skanowanie strony?
Problemy ze skanowaniem pojawiają się wtedy, gdy Googlebot nie może poprawnie dotrzeć do strony lub pobrać potrzebnych zasobów. Przyczyną mogą być awarie serwera, niedostępne pliki albo ograniczenia zapisane w robots.txt. Jeśli robot nie ma dostępu do istotnej części witryny, jego możliwości analizy treści stają się ograniczone.
Równie istotne jest linkowanie wewnętrzne. Podstrony, do których nie prowadzą żadne dostępne linki, mogą być trudniejsze do odnalezienia. Problem może pojawić się również wtedy, gdy serwis tworzy bardzo dużą liczbę nieistotnych adresów URL, na przykład przez filtry, parametry lub różne warianty tych samych stron.
W rozbudowanych witrynach może to prowadzić do sytuacji, w której robot poświęca część zasobów na adresy o niewielkiej wartości zamiast na najważniejsze podstrony. Przejrzysta struktura serwisu i poprawna kontrola dostępu ułatwiają Google sprawniejsze skanowanie treści.
Czym jest indeksowanie strony w Google?
Indeksowanie strony w Google to proces analizowania jej zawartości i zapisywania informacji o niej w indeksie wyszukiwarki. Nie należy utożsamiać go ze skanowaniem. Podczas skanowania Googlebot pobiera stronę i jej zasoby, natomiast podczas indeksowania Google próbuje zrozumieć, czego dotyczy dokument i jaką wartość może mieć dla użytkownika.
Systemy Google analizują między innymi treść, nagłówki, strukturę strony, obrazy oraz powiązania z innymi dokumentami. Na tej podstawie wyszukiwarka rozpoznaje tematykę i znaczenie strony oraz ustala, w jakim kontekście może być ona przydatna. Informacje trafiają następnie do indeksu Google, czyli ogromnego zbioru danych wykorzystywanego podczas obsługi zapytań.
Gdy użytkownik wpisuje frazę w wyszukiwarce, Google korzysta właśnie z tego indeksu. Dopiero spośród zapisanych tam stron wybiera dokumenty, które mogą najlepiej odpowiadać na konkretne zapytanie.
Czy każda zeskanowana strona trafia do indeksu?
Nie każda strona odwiedzona przez Googlebota zostaje zaindeksowana. Sam fakt skutecznego skanowania nie oznacza, że adres będzie później widoczny w wynikach wyszukiwania. Google może pominąć stronę między innymi wtedy, gdy treść jest niedostępna, bardzo podobna do innych dokumentów albo nie wnosi wystarczającej wartości.
Duże znaczenie ma również duplikacja. Jeśli kilka adresów prezentuje tę samą lub niemal identyczną zawartość, Google może wybrać jeden z nich jako wersję kanoniczną. Pozostałe adresy nie muszą być traktowane jako osobne dokumenty w indeksie.
Właściciel witryny może przekazywać wyszukiwarce sygnały dotyczące preferowanej wersji strony, między innymi poprzez poprawną strukturę linkowania i oznaczenie adresu kanonicznego. Problemy tego typu warto również sprawdzać podczas audyt seo strony, ponieważ mogą wpływać na sposób, w jaki wyszukiwarka interpretuje i indeksuje poszczególne adresy.
Indeksowanie nie jest więc automatycznym następstwem publikacji, lecz kolejnym etapem oceny i porządkowania informacji przez Google.
Jak Google wybiera wyniki wyszukiwania?
Google wybiera wyniki wyszukiwania na podstawie informacji zapisanych w swoim indeksie i dopasowuje je do zapytania użytkownika. System analizuje, czego dana osoba prawdopodobnie szuka, a następnie porównuje tę potrzebę z treściami, które wcześniej zostały zeskanowane i zaindeksowane. Samo występowanie konkretnego słowa na stronie nie wystarcza. Liczy się również znaczenie całej treści oraz jej zgodność z intencją wyszukiwania.
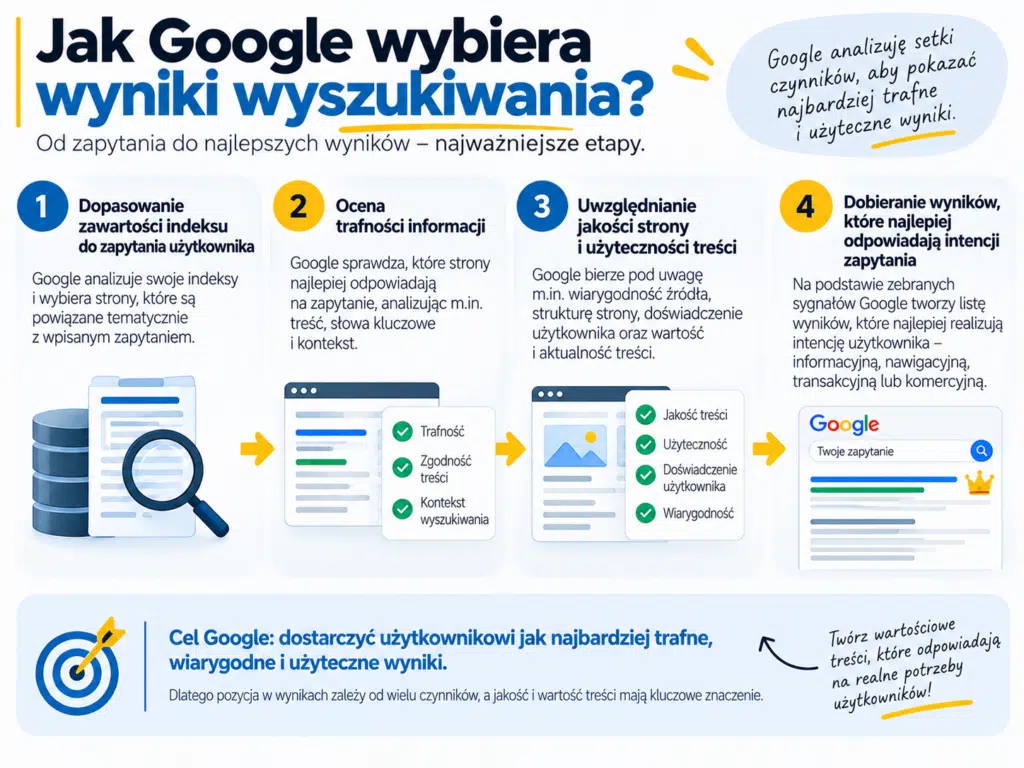
Google ocenia także trafność, jakość i użyteczność informacji. Strona powinna odpowiadać na pytanie użytkownika w sposób jasny, wiarygodny i wystarczająco kompletny. Treści, które jedynie powtarzają ogólne informacje lub powstają głównie z myślą o manipulowaniu widocznością, mogą być mniej pomocne niż materiały tworzone z myślą o rzeczywistych potrzebach odbiorcy.
Jeśli użytkownik szuka instrukcji, wyszukiwarka będzie próbowała pokazać treści rozwiązujące konkretny problem. Jeśli interesuje go produkt, usługa lub lokalna firma, charakter wyników może być inny.
Google stara się więc dopasować nie tylko temat strony, ale również sposób odpowiedzi do celu zapytania, aby użytkownik możliwie szybko znalazł potrzebną informację.
Jak AI zmienia sposób działania Google?
Sztuczna inteligencja pomaga Google lepiej rozumieć znaczenie zapytań, treść stron oraz zależności między informacjami. Wyszukiwarka nie musi więc opierać się wyłącznie na dokładnym dopasowaniu wpisanych słów. Systemy AI mogą analizować kontekst pytania, rozpoznawać podobne pojęcia i wybierać treści, które odpowiadają rzeczywistej potrzebie użytkownika.
Rozwój generatywnej AI sprawił, że Google może nie tylko prezentować klasyczne wyniki, ale również tworzyć rozbudowane odpowiedzi bezpośrednio na stronie wyszukiwania. Przykładem są AI Overviews, które mogą łączyć informacje pochodzące z różnych źródeł i przedstawiać je użytkownikowi w bardziej syntetycznej formie.
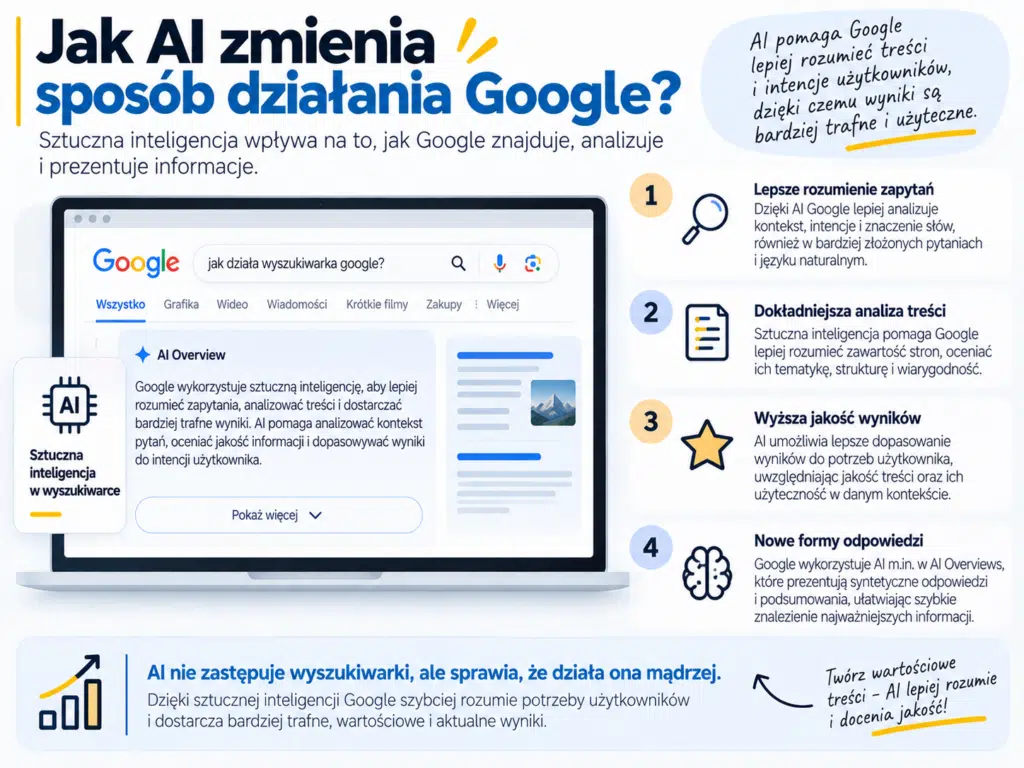
Nie oznacza to jednak, że tradycyjne SEO straciło znaczenie. Google wskazuje, że funkcje wyszukiwania oparte na generatywnej AI nadal korzystają z podstawowych systemów rankingowych i danych dostępnych w indeksie. Dobra struktura techniczna, wartościowa treść, możliwość indeksowania oraz trafne odpowiadanie na potrzeby użytkowników nadal pozostają podstawą widoczności.
Google może tworzyć odpowiedzi AI, korzystając z informacji znajdujących się w swoim indeksie wyszukiwarki. Systemy wyszukują trafne i aktualne strony, analizują zawarte na nich informacje, a następnie wykorzystują je do przygotowania odpowiedzi dopasowanej do zapytania użytkownika.
Jednym z mechanizmów wykorzystywanych w tym procesie jest generowanie wspomagane wyszukiwaniem, czyli RAG. Pozwala ono oprzeć odpowiedź na materiałach pobranych z indeksu Google, co ma poprawiać jej aktualność i zgodność z dostępnymi źródłami. Google może również wykonywać dodatkowe, powiązane zapytania, aby zebrać więcej informacji potrzebnych do wyjaśnienia tematu.
W odpowiedziach generowanych przez AI mogą pojawiać się linki prowadzące do stron źródłowych. Dla właścicieli witryn oznacza to, że poprawnie zaindeksowana, użyteczna i wiarygodna treść może zyskać widoczność nie tylko w klasycznych wynikach wyszukiwania, lecz także w generatywnych formatach Google.
Dlaczego strona może nie pojawiać się w Google?
Strona może nie pojawiać się w Google, jeśli wyszukiwarka jej nie odkryła, nie mogła jej poprawnie zeskanować albo nie zdecydowała się uwzględnić jej w indeksie. Dotyczy to szczególnie nowych podstron, do których nie prowadzą linki wewnętrzne i których adres nie został wskazany w mapie witryny. Samo opublikowanie treści nie oznacza więc automatycznej widoczności w wynikach wyszukiwania.
Potrzebujesz skuteczniejszego SEO?
Przyczyną mogą być także problemy techniczne. Niedostępny serwer, blokada dostępu dla Googlebota, ustawienie noindex albo niewłaściwa konfiguracja adresów kanonicznych mogą utrudnić lub całkowicie uniemożliwić indeksowanie.
Podobny problem pojawia się przy dużej liczbie stron zawierających tę samą lub bardzo podobną treść, ponieważ Google może uznać jeden adres za wersję właściwą, a pozostałych nie wyświetlać osobno.
Znaczenie ma również jakość i użyteczność zawartości strony. Jeśli treść jest bardzo uboga, powiela informacje dostępne na innych podstronach albo nie daje użytkownikowi wyraźnej wartości, samo poprawne działanie techniczne nie gwarantuje indeksowania ani widoczności. Przy diagnozowaniu problemu trzeba więc sprawdzić zarówno dostępność adresu dla Google, jak i jego zawartość oraz relację z innymi stronami w serwisie.
Podsumowanie
Jak działa wyszukiwarka Google? Najpierw odkrywa adres strony, następnie Googlebot ją skanuje, a później system analizuje treść i może dodać ją do indeksu. Dopiero wtedy strona ma szansę pojawić się przy odpowiednim zapytaniu użytkownika.
Samo opublikowanie strony nie gwarantuje obecności w wynikach. Na indeksowanie wpływają między innymi dostępność techniczna, jakość treści, linkowanie wewnętrzne, duplikacja oraz możliwość poprawnego odczytania strony przez Google.
Teraz na pewno łatwiej rozpoznasz, na którym etapie pojawia się problem z widocznością i co należy sprawdzić. Zrozumienie skanowania, indeksowania i dopasowania wyników ułatwia także podejmowanie trafniejszych decyzji SEO.
FAQ - Jak działa wyszukiwarka Google?
Dlaczego moja strona nie pojawia się w Google po publikacji?
Strona może nie pojawiać się w Google, jeśli wyszukiwarka jeszcze jej nie odkryła, nie mogła jej poprawnie zeskanować albo nie dodała jej do indeksu. Sprawdź, czy prowadzą do niej linki wewnętrzne, czy znajduje się w mapie witryny oraz czy nie została wykluczona z indeksowania przez ustawienia techniczne.
Czy dodanie strony do mapy witryny gwarantuje indeksowanie?
Dodanie adresu do mapy witryny nie gwarantuje indeksowania w Google. Sitemap pomaga wyszukiwarce odkryć ważne adresy URL i może ułatwić ich ponowne odwiedzenie po aktualizacji. Google nadal samodzielnie ocenia, czy dana strona powinna znaleźć się w indeksie, dlatego liczą się również dostępność, treść i brak problemów technicznych.
Czy zeskanowana strona zawsze trafia do indeksu Google?
Zeskanowanie strony przez Googlebota nie oznacza automatycznie jej indeksowania. Po pobraniu zawartości Google analizuje tematykę, strukturę, jakość oraz podobieństwo do innych dokumentów. Jeśli kilka adresów prezentuje bardzo podobną treść, wyszukiwarka może wybrać jeden z nich jako wersję kanoniczną i nie indeksować pozostałych osobno.
Co może uniemożliwić Google poprawne skanowanie strony?
Skanowanie strony mogą utrudniać problemy z serwerem, niedostępne zasoby, blokady w pliku robots.txt oraz nieprawidłowe linkowanie wewnętrzne. Problemem może być również bardzo duża liczba nieistotnych adresów URL. Szybkim testem jest sprawdzenie, czy najważniejsze podstrony są dostępne z innych miejsc serwisu i możliwe do odwiedzenia przez Googlebota.
Czy AI zmienia podstawowe zasady SEO w Google?
Rozwój generatywnej AI nie usuwa podstawowych zasad SEO. Funkcje takie jak AI Overviews nadal korzystają z informacji dostępnych w indeksie Google oraz podstawowych systemów rankingowych. Dlatego nadal znaczenie mają możliwość skanowania, poprawne indeksowanie, dobra struktura techniczna oraz treści odpowiadające na rzeczywiste potrzeby użytkowników.

Jestem copywriterką z wykształceniem technicznym, ukończyłam Inżynierię Środowiska na Politechnice Częstochowskiej, gdzie zdobyłam tytuł magistra inżyniera. Ta techniczna ścieżka edukacji nieoczekiwanie stała się fundamentem mojej kariery w copywritingu, dając mi unikalne umiejętności analizy i przekładania skomplikowanych koncepcji na prosty, przystępny język. Specjalizuję się w tworzeniu treści marketingowych, które łączą w sobie precyzję techniczną z kreatywnością słowa, pomagając firmom zwiększać ich widoczność online. Moje doświadczenie pozwala mi na tworzenie angażujących treści dostosowanych do potrzeb klientów z różnych branż, od artykułów blogowych po kompleksowe kampanie reklamowe. Wierzę w moc słuchania i zrozumienia potrzeb, co pozwala mi tworzyć treści, które naprawdę rezonują z odbiorcami.


